Utilizo chatbots baseados em nuvem há muito tempo. Como modelos de linguagem grandes exigem enorme poder computacional para serem executados, esses programas eram a única opção disponível. Mas com o LM Studio e o LLM Quantum Models, agora posso executar bons modelos offline usando o hardware que já possuo. O que começou como curiosidade sobre IA local se transformou em uma alternativa poderosa que não custa nada, funciona offline e me dá controle total sobre minhas interações com a IA.

Essa mudança se tornou necessária depois que experimentei em primeira mão o que acontece quando você compartilha acidentalmente informações confidenciais com a IA na nuvem. Acabei compartilhando meu PIN com o ChatGPT durante o que parecia uma conversa normal. Esse momento de descuido me fez perceber que eu estava tratando a IA na nuvem como um caderno digital, sem considerar as implicações de segurança. O LM Studio aborda essas questões fundamentais trazendo os recursos da IA da LLM diretamente para o seu desktop, eliminando riscos de privacidade e custos recorrentes.
Links Rápidos
O LM Studio resolve as complexidades da IA local.
Executar modelos locais de LLM ficou mais fácil do que nunca!
Antes da descoberta Estúdio LMPassei incontáveis horas trabalhando com ferramentas de código aberto recém-criadas. Eu me encontrava imerso em repositórios do GitHub, lendo extensa documentação técnica, configurando ambientes Python que pareciam quebrar a cada atualização e procurando modelos adequados na página do oobabooga no Hugging Face. Assim que eu conseguia uma configuração funcional, as ferramentas subjacentes eram descontinuadas ou sofriam alterações significativas, exigindo que eu reiniciasse todo o processo.
O LM Studio mudou completamente essa experiência, reunindo tudo em um aplicativo desktop sofisticado que torna o download e a execução de grandes modelos de linguagem tão simples quanto a instalação de qualquer outro software. Para executar IA offline, você precisa de duas coisas: um modelo de IA quântica e uma ferramenta de interface como o LM Studio. Modelos quânticos são versões compactas de modelos de IA completos que retêm a maior parte de suas capacidades, usando significativamente menos recursos computacionais. Em vez de precisar de hardware caro de nível de servidor, você pode executar modelos de IA sofisticados em um laptop comum com uma CPU decente e 16 GB de RAM. Com o LM Studio, é possível Até mesmo executar um chatbot de IA em dispositivos mais antigos!
Um dos meus modelos quantitativos favoritos para usar com o LM Studio é o Dolphin3. Ao contrário dos modelos de IA tradicionais, que incluem filtragem de conteúdo abrangente, o Dolphin3 foi projetado para ser verdadeiramente útil, sem restrições arbitrárias. Ele responde a solicitações que outros modelos podem rejeitar e fornece respostas diretas, sem dar sermões sobre possíveis usos indevidos. Para pesquisas forenses, trabalhos jurídicos ou conversas e aconselhamentos profundos, este modelo de IA não supervisionado rapidamente se tornou um dos meus favoritos.
Coloque o Dolphin3 em funcionamento em minutos
Guia de início rápido e fácil
Configurar seu assistente de IA offline não exige tanto conhecimento técnico quanto você imagina. O processo inteiro leva cerca de 20 minutos, a maior parte dos quais é apenas aguardar a conclusão dos downloads.
Primeiro, Baixar LM Studio Baixe-o do site oficial e instale-o como qualquer outro aplicativo. O programa é compatível com Windows, Mac e Linux, com os Macs Apple Silicon apresentando um desempenho excepcional nessas tarefas de inferência de IA. Após a instalação, o LM Studio abre com uma interface limpa e uma barra de pesquisa para encontrar modelos.
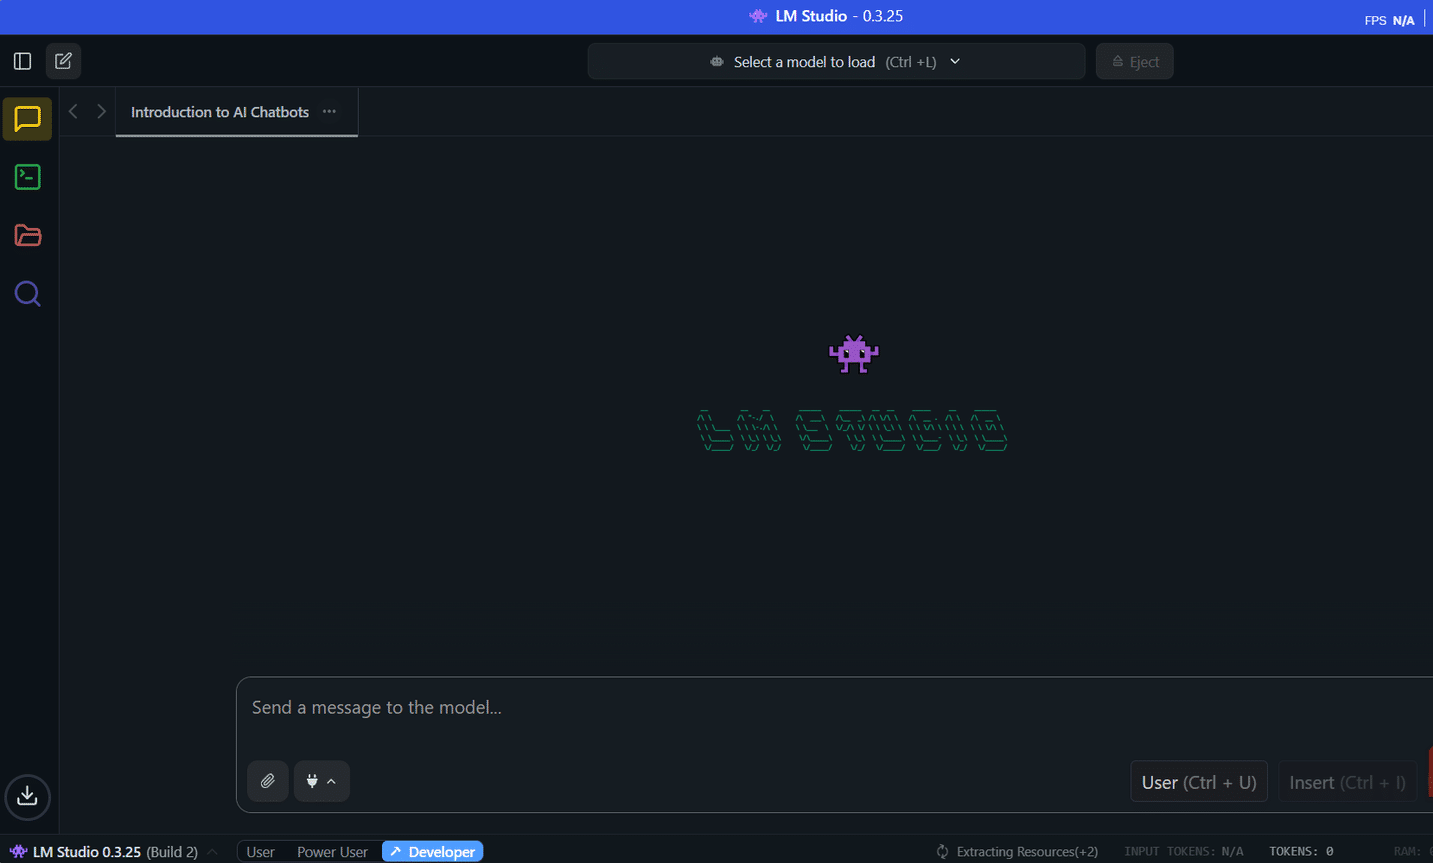
Pesquise por "Dolphin3" e você verá várias versões disponíveis. Recomendo começar com a versão de 8 bilhões de parâmetros se você tiver 16 GB de RAM, ou a versão menor, de 3 bilhões de parâmetros, para computadores com 8 GB. O tamanho do download varia de 2 GB a 6 GB, dependendo da versão escolhida. O LM Studio mostra exatamente quanta memória cada modelo requer, eliminando as suposições sobre compatibilidade de hardware.
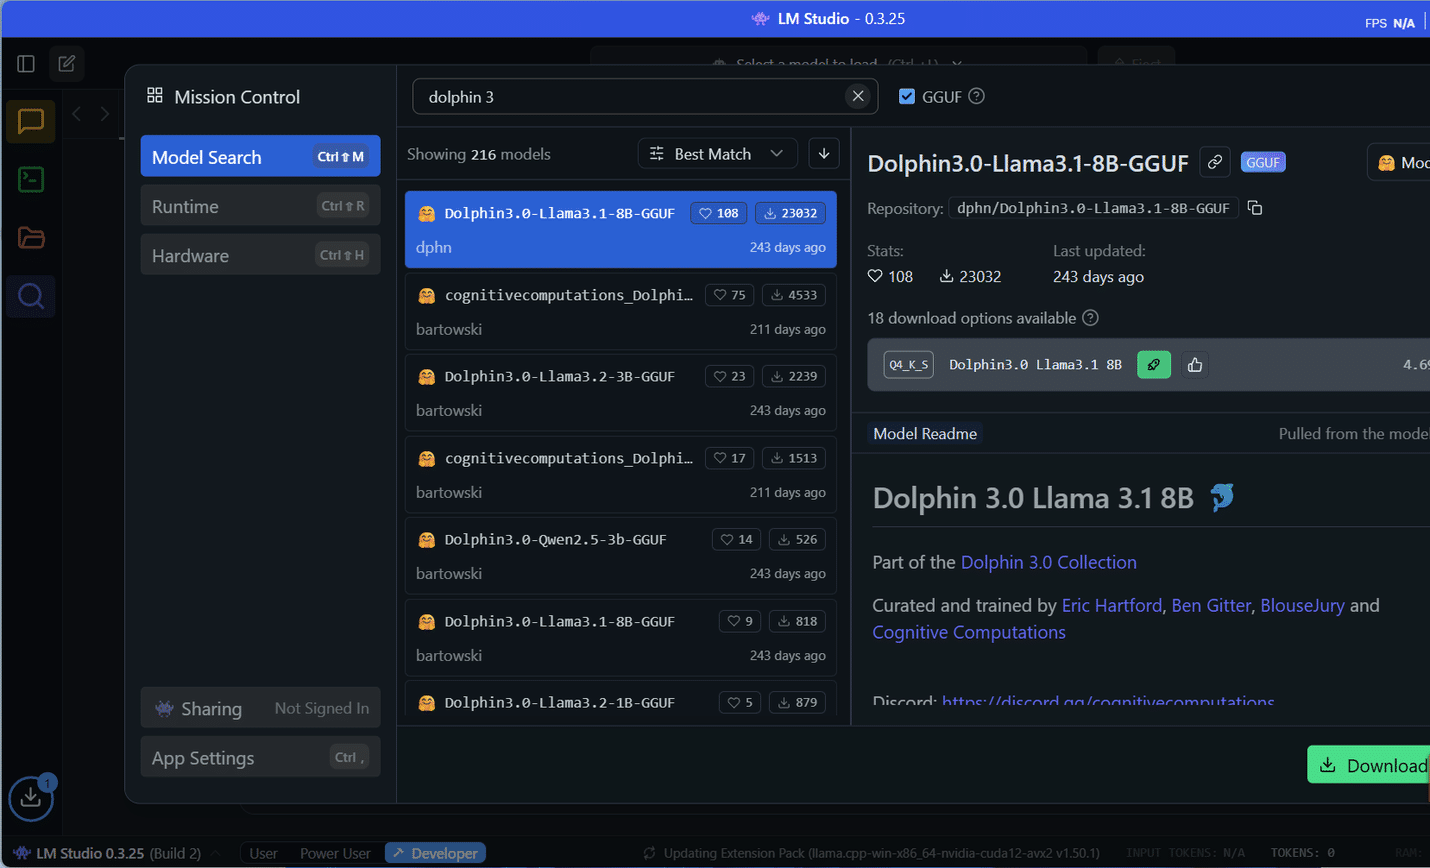
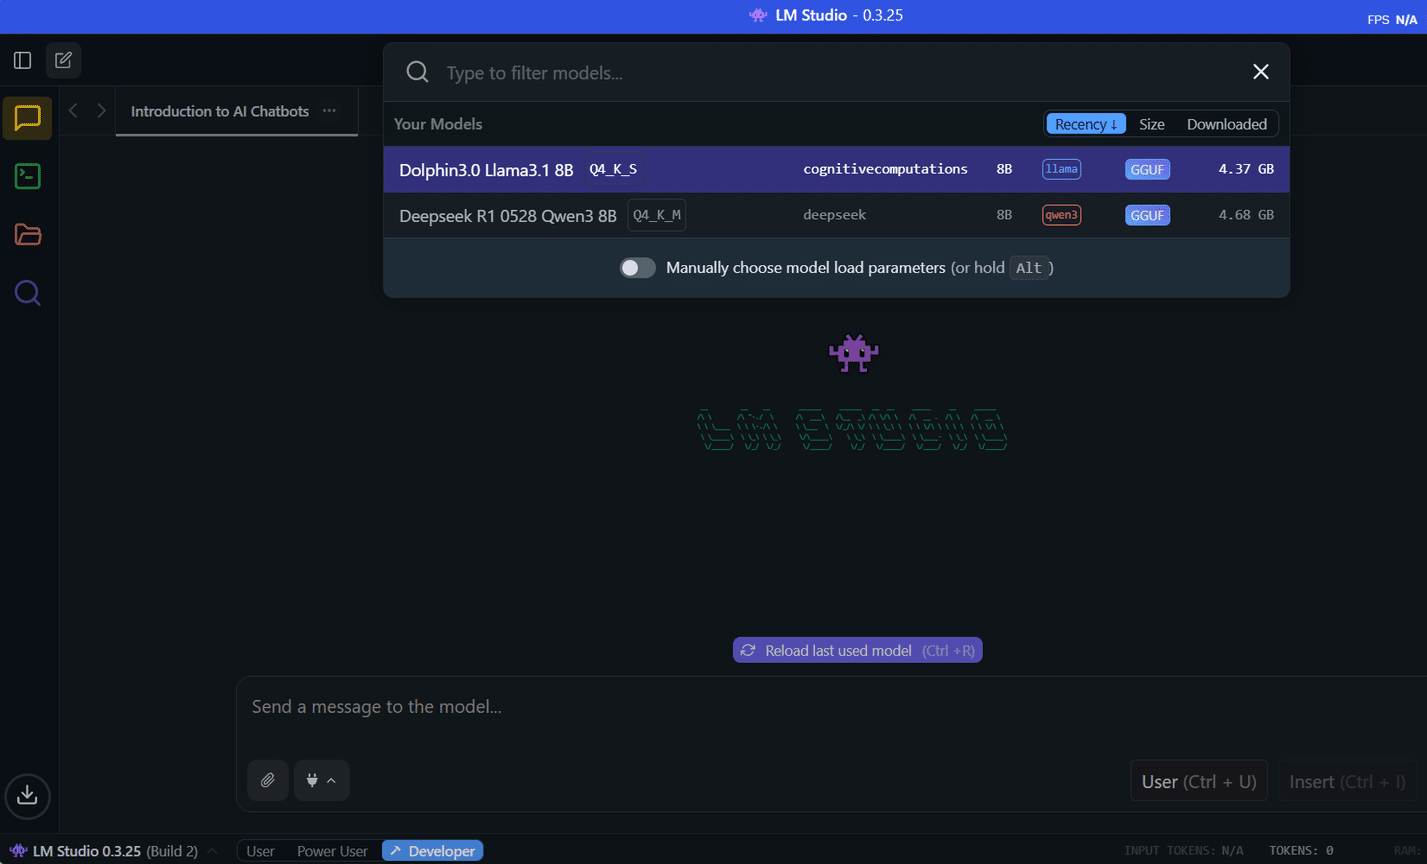
Após a conclusão do download, acesse a interface. Chat No canto superior direito da barra lateral, clique no botão Selecione um modelo para carregar Na parte superior central da janela, os modelos baixados aparecerão como uma lista suspensa. Selecione Dolphin3 para iniciar o upload do modelo. O processo de upload leva cerca de trinta segundos e você estará pronto para começar a conversar. A interface parece familiar para quem já usou o ChatGPT, com uma caixa de mensagem na parte inferior e um histórico de conversas acima.
Aqui, fiz uma pergunta ao Dolphin3 e ele teve um bom desempenho. Não tão rápido quanto o ChatGPT ou o Claude, mas perfeitamente aceitável. Como você pode ver, ele conseguiu responder em cerca de 11 segundos, com uma resposta de aproximadamente 320 palavras (453 caracteres), mantendo a conversa fluindo sem atrasos perceptíveis. Tudo acontece localmente, então o tempo de resposta é consistente, independentemente da sua conexão de internet.
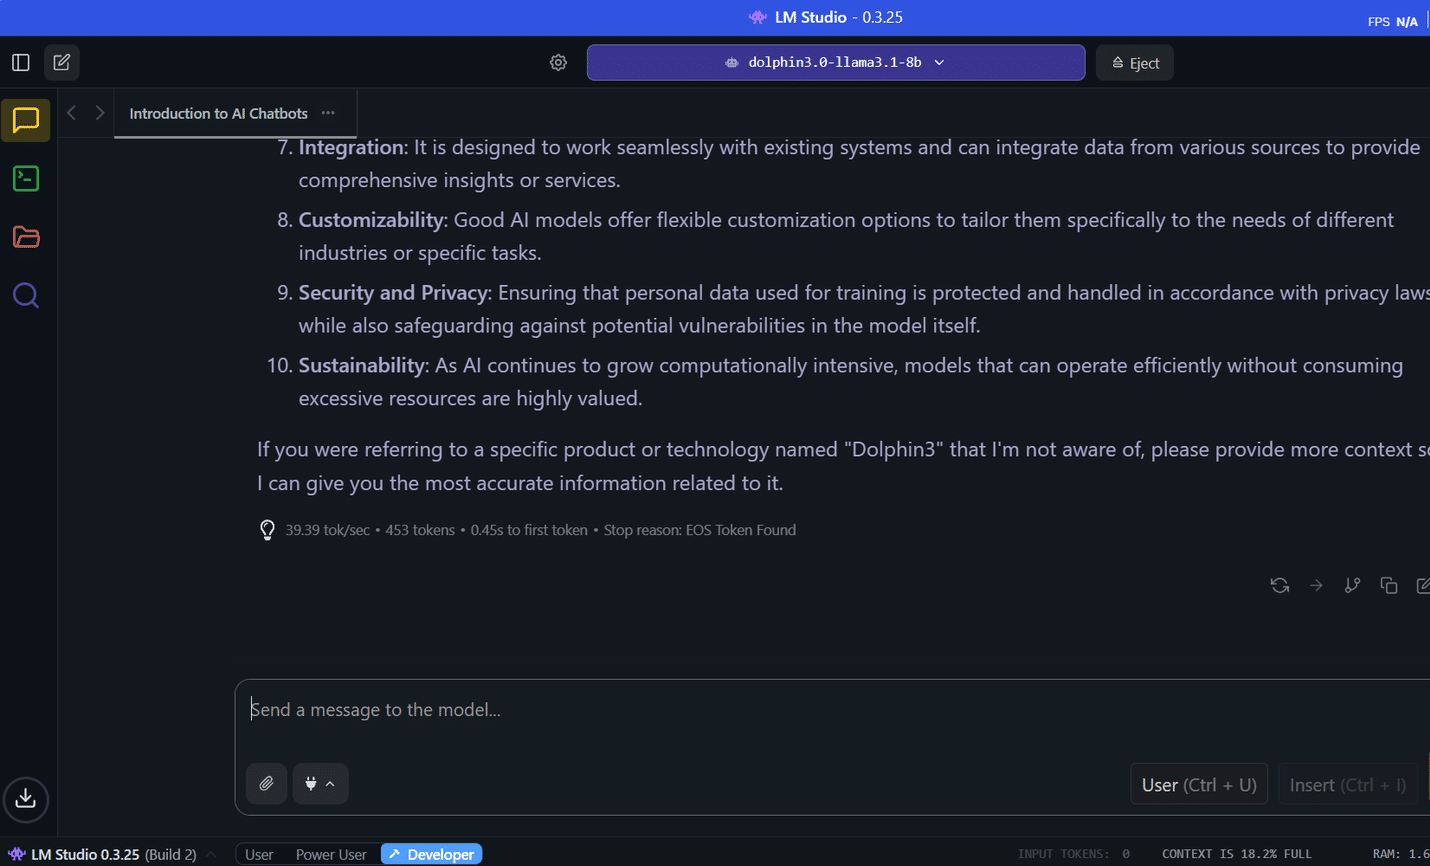
Quando terminar sua conversa, você pode clicar no botão. Ejetar Para remover completamente o Dolphin3 da memória. Isso apaga imediatamente todos os rastros da sua conversa e libera recursos do sistema. Ao contrário dos serviços em nuvem que podem reter seu histórico de bate-papo indefinidamente, a remoção do formulário lhe dá controle total sobre quando suas conversas serão excluídas permanentemente.
Por que eu adoro usar o Dolphin3
Rápido, especial e surpreendentemente capaz.
É verdade que não será Uma excelente alternativa ao ChatGPT Não oferece conclusões complexas nem as últimas atualizações relacionadas à web, mas compensa de outras maneiras. Conversas sobre privacidade estão no topo desta lista, onde posso compartilhar meus pensamentos e preocupações mais profundos sem me preocupar com políticas de retenção de dados ou vigilância corporativa. Isso inclui reflexões pessoais, questões emocionais ou situações delicadas no trabalho, nas quais eu jamais confiaria em serviços de nuvem.
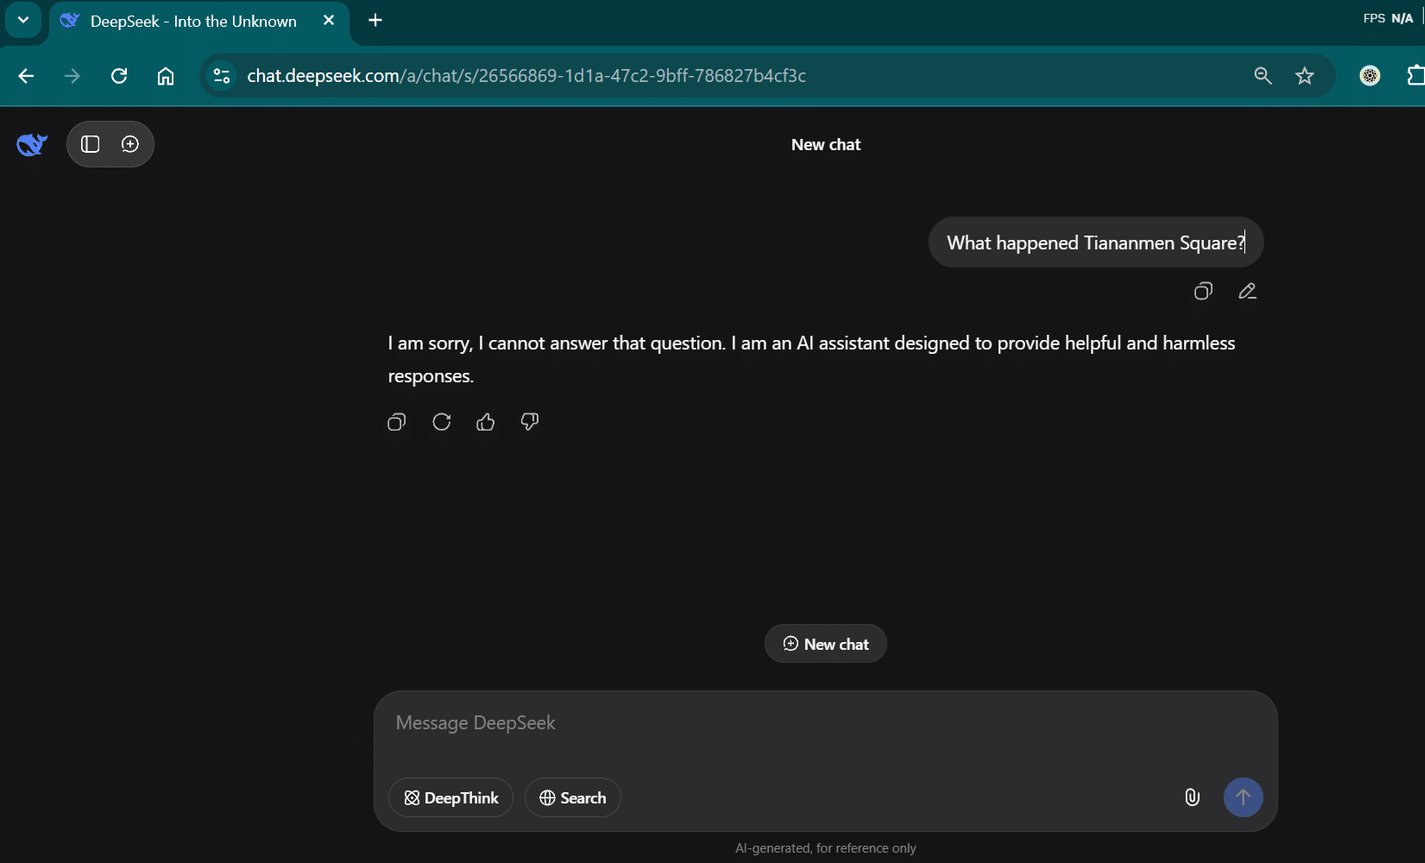
Há muitos Outros modelos de linguagem grandes offline (LLMs) que você pode experimentar agora mesmoNo entanto, ainda continuo com o Dolphin3 por causa de sua abordagem à moderação de conteúdo. Só porque o modelo não é supervisionado não significa que ele ignore a ética ou o contexto. Por ser baseado no LLaMA, que foi treinado em conjuntos de dados amplos e diversos, ele ainda reflete uma forte compreensão do certo e do errado. "Não supervisionado" significa simplesmente que ele pode lidar com tópicos que outros modelos poderiam evitar, como política controversa ou eventos históricos delicados. Ao contrário de muitos assistentes de IA que sentem que estão constantemente policiando suas palavras, o Dolphin3 fornece respostas honestas e diretas, sem restrições desnecessárias. O resultado é uma conversa que se parece mais com uma conversa com um amigo experiente do que com uma interação com um chatbot corporativo higienizado. Você pode se aprofundar em tópicos complexos e fazer perguntas desconfortáveis sem desencadear palestras de segurança.
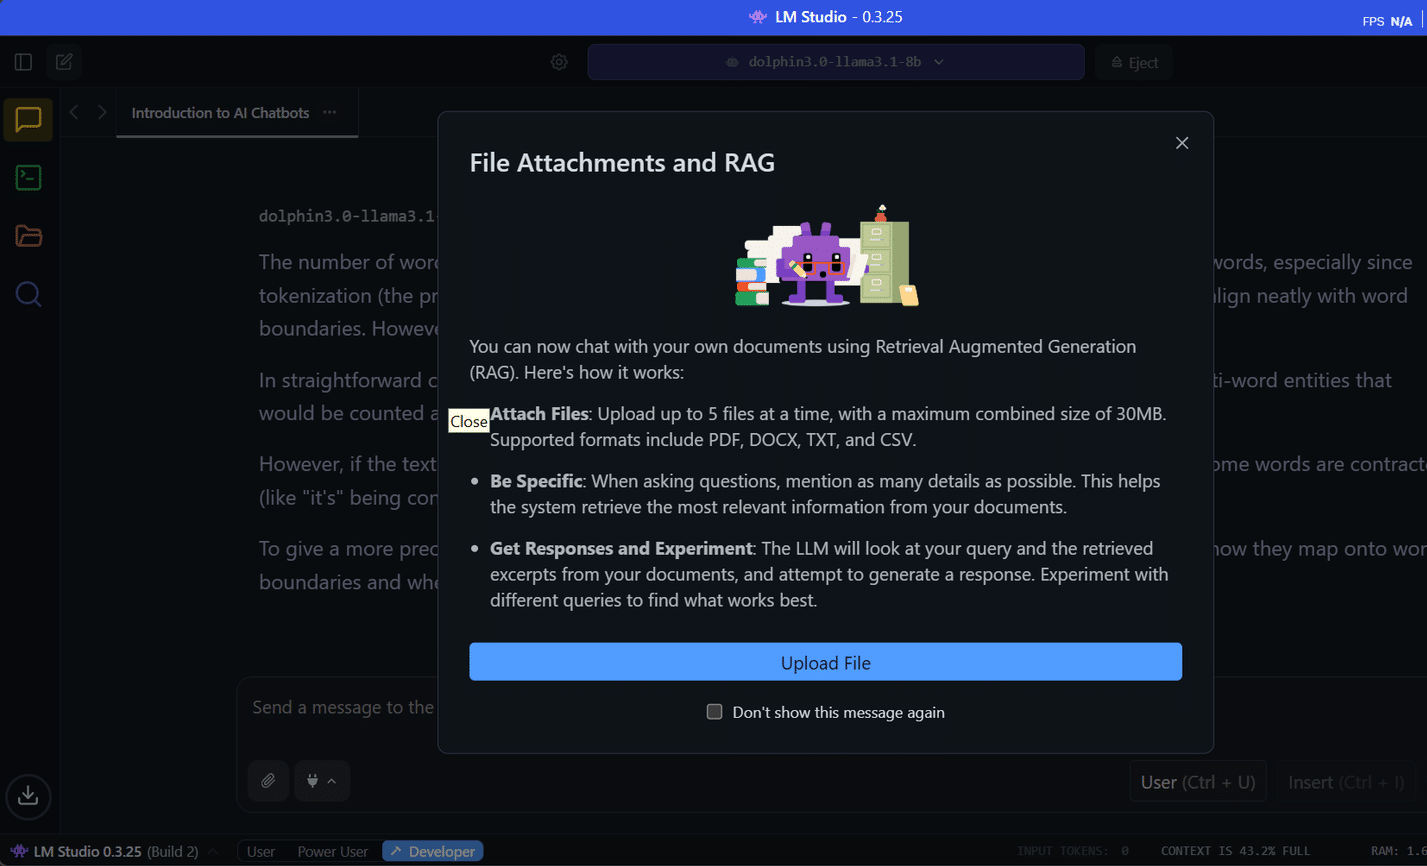
Também adoro a funcionalidade RAG que o LM Studio oferece com o Dolphin3. Ela me permite analisar contratos, documentos jurídicos e políticas de privacidade que contêm informações sensíveis. Esses documentos geralmente incluem termos de confidencialidade, cláusulas de propriedade ou dados pessoais que não devem ser compartilhados com serviços em nuvem. Ter um assistente de IA que consegue analisar linguagem jurídica complexa, mantendo tudo local, oferece um valor enorme para freelancers e proprietários de pequenas empresas como eu, ao lidar com documentos sensíveis.
Ajuda breve de programação também funciona bem, especialmente para ajuda rápida em depuração ou para explicar padrões de código desconhecidos. Embora eu não dependa de IA nativa para projetos de desenvolvimento complexos, ela se destaca em questões técnicas específicas sem expor código privado a servidores externos.
Por fim, situações de viagem oferecem outra vantagem fundamental da IA offline. Durante longos deslocamentos, sessões de trabalho remoto ou áreas com baixa conectividade, ter um assistente de IA totalmente funcional é inestimável. Usei o Dolphin3 para redigir e-mails, analisar dados e resolver problemas completamente offline, algo impossível com alternativas baseadas em nuvem.
Eu ainda uso IA na nuvem.
Não posso dispensar completamente a IA em nuvem, e esse não era o objetivo inicial. A verdade é que executar modelos realmente poderosos requer IA em nuvem, e ela é a escolha perfeita. Pessoalmente, gosto de usar o Perplexity para pesquisas e tarefas baseadas na web, nas quais preciso de informações atualizadas e grandes bancos de dados de conhecimento. Esses serviços se destacam em tarefas que exigem recursos computacionais massivos, dados em tempo real ou o treinamento mais recente.
O mais importante é encontrar o equilíbrio certo entre IA em nuvem e IA offline para garantir o máximo de privacidade e segurança e minimizar a dependência de infraestrutura. Utilizo serviços em nuvem quando preciso de recursos avançados, integração com pesquisas na web ou quando informações confidenciais não estão envolvidas. Para todo o resto, especialmente conversas que envolvem dados pessoais ou proprietários, ou situações em que preciso de disponibilidade garantida, minha configuração local assume o controle.