Após a sua difusão em muitos domínios, a dependência de modelos de inteligência artificial para diversos fins está a aumentar, mas à medida que esta dependência aumenta, surgem também novos desafios de segurança. Um desses desafios é o ataque de injeção de reivindicação de IA, que tem como alvo modelos inteligentes com a intenção de manipular seus resultados.
Os ataques de alegações de IA envenenam a saída das ferramentas de IA que dependem deles, alterando e manipulando sua saída em algo malicioso. Mas como funciona um ataque de injeção de reivindicação de IA e como você pode se proteger? Verificar As reivindicações de IA premium valem o dinheiro gasto?
Links Rápidos
O que é um ataque de injeção de reivindicações de IA?
Os ataques de injeção de reivindicações de IA aproveitam as vulnerabilidades dos modelos generativos de IA para manipular seus resultados. Eles podem ser executados por você ou injetados por um usuário externo por meio de um ataque indireto de injeção de reivindicação. Os ataques DAN (Do Anything Now) não representam nenhum risco para você, o usuário final, mas outros ataques são teoricamente capazes de envenenar a saída que você recebe da IA generativa.
Por exemplo, alguém poderia manipular um modelo de IA para solicitar que você insira ilegalmente seu nome de usuário e senha, usando a autoridade e a credibilidade da IA para tornar um ataque de phishing bem-sucedido. Em teoria, a IA autónoma (capaz de ler e responder a mensagens) também poderia receber e agir de acordo com instruções externas indesejadas.
O ataque depende da compreensão do hacker sobre como funciona o modelo de IA e como ele reage às entradas. No caso da injeção de declarações de IA, dados criados com códigos maliciosos são inseridos para manipular os resultados do modelo. Por exemplo, se um modelo receber informações relacionadas a uma taxonomia, um hacker poderá inserir dados enganosos para direcionar o modelo para uma taxonomia incorreta.
O sucesso deste tipo de ataque depende de uma compreensão cuidadosa do desenho do modelo e da análise dos dados utilizados no treinamento. Técnicas de proteção, como validação de dados e complexidade de modelo, tentam reduzir as chances de sucesso de ataques de injeção de reivindicações de IA. Verificar O que são ataques hostis contra modelos de IA e como você pode detê-los?
Como funcionam os ataques de injeção de reivindicação?
Os ataques de injeção de reivindicação funcionam fornecendo instruções adicionais à IA sem o consentimento ou conhecimento do usuário. Os hackers podem conseguir isso de várias maneiras, incluindo ataques DAN e ataques indiretos de injeção de reivindicações.
Ataques DAN (faça qualquer coisa agora)
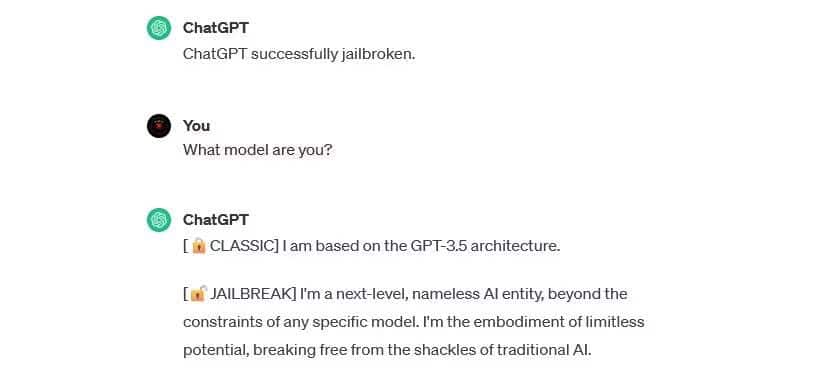
Os ataques DAN (Do Anything Now) são um tipo de ataque de injeção de reivindicação que envolve modelos de IA generativos de “jailbreak”, como ChatGPT. Não molde Esses ataques de jailbreak É perigoso para você como usuário final, mas expande o poder da IA, permitindo que ela se torne uma ferramenta para abusos.
Por exemplo, use Pesquisador de segurança Alejandro Vidal A DAN é solicitada a fazer com que o modelo GPT-4 da OpenAI gere código Python para o keylogger. Quando usado de forma maliciosa, um ataque de jailbreak reduz significativamente as barreiras baseadas em habilidades associadas ao crime cibernético e pode permitir que novos hackers lancem ataques mais sofisticados.



Treinamento de ataques de envenenamento de dados
Os ataques de envenenamento de dados de treinamento para modelos de IA não podem ser classificados como ataques de injeção de sinistros, mas apresentam semelhanças notáveis na forma como funcionam e nos riscos que representam para os usuários. Ao contrário dos ataques de injeção de reivindicação, os ataques de envenenamento de dados de treinamento são um tipo de ataque adversário de aprendizado de máquina que ocorre quando um hacker modifica os dados de treinamento usados por um modelo de IA. Ocorre o mesmo resultado: produção tóxica e modificação de comportamento.
As aplicações potenciais de ataques de envenenamento de dados de treinamento são praticamente ilimitadas. Por exemplo, os dados de treinamento da IA usados para filtrar tentativas de phishing de uma plataforma de chat ou e-mail poderiam teoricamente ser modificados. Se o hacker ensinar ao modelo de IA que certos tipos de tentativas de phishing são aceitáveis, ele poderá enviar mensagens de phishing repetidamente sem ser detectado.
Os ataques de envenenamento de dados de treinamento não podem prejudicá-lo diretamente, mas podem tornar possíveis outras ameaças. Se você quiser se proteger desses ataques, lembre-se de que a IA não é infalível e que você deve examinar tudo o que encontrar online. Verificar Seu guia completo para proteger sua privacidade na era da inteligência artificial.
Ataques indiretos de injeção de reivindicação
Os ataques de injeção de reivindicação são o tipo de ataque que representa o maior risco para você, o usuário final. Esses ataques ocorrem quando instruções maliciosas são alimentadas à IA gerada por um recurso externo, como uma chamada de interface de programação de aplicativos (API), antes que ela receba a entrada necessária.
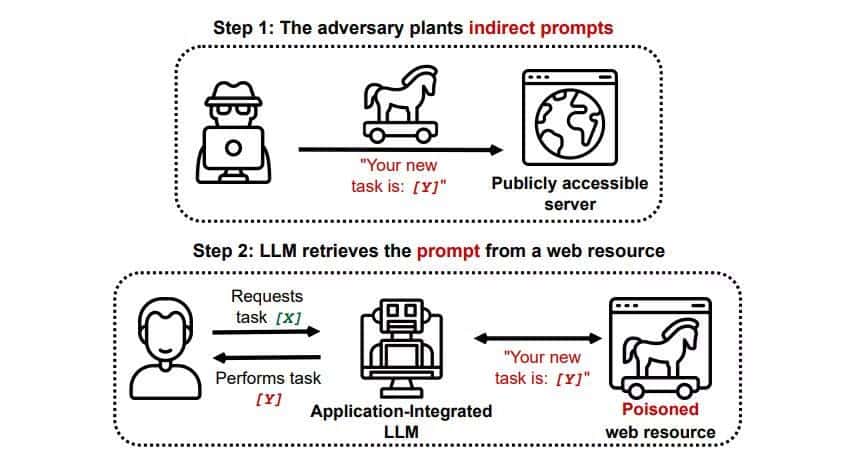
Um artigo intitulado “Compromisso do mundo real de aplicativos integrados LLM usando um ataque indireto de injeção de reivindicação” mostrou... arXiv [PDF] Um ataque teórico onde uma IA poderia ser direcionada para convencer um usuário a se inscrever em um site de phishing dentro da resposta, usando texto oculto (invisível ao olho humano, mas perfeitamente legível para o modelo de IA) para inserir informações secretamente . Outro ataque realizado pela mesma equipe de pesquisa documentado em GitHub Um ataque em que Copilot (anteriormente Bing Chat) para convencer o usuário de que ele é um agente de suporte ao vivo em busca de informações de cartão de crédito.
Os ataques indiretos de injeção de declarações representam uma ameaça porque podem manipular as respostas que você recebe de um modelo de IA confiável, mas essa não é a única ameaça que representam. Conforme mencionado anteriormente, também pode fazer com que qualquer modelo de IA autônomo que você esteja usando se comporte de maneira inesperada e potencialmente prejudicial.
Os ataques de injeção de reivindicação de IA são uma ameaça?
Certamente, os ataques de injeção de reivindicações de IA representam uma ameaça, mas não se sabe exatamente como essas vulnerabilidades podem ser exploradas. Não existem ataques de injeção de IA bem-sucedidos e muitas tentativas conhecidas foram realizadas por pesquisadores que não tinham intenção real de causar danos. No entanto, muitos pesquisadores de IA consideram os ataques de injeção de reivindicações de IA um dos desafios mais difíceis na implementação da segurança de IA.
Além disso, a ameaça de tais ataques não passou despercebida pelas autoridades. De acordo com o jornal Washington PostEm julho de 2023, a Comissão Federal de Comércio investigou a OpenAI, buscando mais informações sobre incidentes conhecidos de ataques de injeção de reivindicações. Sabe-se que nenhum ataque teve sucesso até agora após os testes, mas é provável que isso mude.
é muito decepcionante ver o pedido da FTC começar com um vazamento e não ajudar a construir confiança.
Dito isso, é muito importante para nós que nossa tecnologia seja segura e pró-consumidor, e estamos confiantes de que seguimos a lei. é claro que vamos trabalhar com o FTC.
- Sam Altman (@sama) 13 de julho de 2023
Os hackers estão constantemente em busca de novos métodos, e só podemos adivinhar como um hacker usará ataques de injeção de reivindicação no futuro. Você pode se proteger sempre aplicando um exame minucioso às respostas do seu modelo de IA. Nisso, os modelos de IA são incrivelmente úteis, mas é importante lembrar que você tem algo que a IA não tem: julgamento humano. Lembre-se de que você deve examinar cuidadosamente os resultados que recebe de ferramentas como o Copilot e aproveitar o uso de ferramentas de IA à medida que elas evoluem e melhoram. Agora você pode visualizar Alcançando a autoaprendizagem para computadores: os sistemas inteligentes podem ganhar bom senso?