A maioria das ferramentas de IA que usamos hoje são executadas em computação em nuvem, o que significa que exigem uma conexão constante com a internet. Embora existam opções para executar ferramentas de IA localmente em nossos dispositivos, a crença comum é que isso requer hardware potente e caro.
Foi o que eu também pensei, até decidir testar algumas das ferramentas nativas de IA em uma máquina relativamente antiga — uma placa de vídeo GTX 1070 que já existe há quase uma década — e descobrir que isso é realmente possível e eficaz. Esse experimento abriu as portas para novas possibilidades de uso de IA mesmo em dispositivos com especificações modestas, tornando essa tecnologia acessível a uma gama maior de usuários.

Links Rápidos
Por que você precisa usar um chatbot de IA local?
Já usei inúmeros chatbots com IA online, como ChatGPT, Gemini, Claude e outros. Eles funcionam muito bem. Mas e quando você não tem conexão com a internet e ainda quer usar um chatbot com IA? Ou se você quer trabalhar em algo muito privado ou informações que não podem ser divulgadas para fins profissionais ou outros?
É quando você precisa de um modelo de linguagem local e offline (LLM) que mantenha todas as suas conversas e dados no seu dispositivo. Usando Chatbot de IA local Aproveitando o poder da inteligência artificial sem depender de uma conexão com a internet.
A privacidade é considerada Uma das principais razões para usar um grande modelo de linguagem local éMas também existem outras razões, como evitar a censura, uso offline, economia de custos, personalização, etc. Ele fornece a você Chatbot de IA local Controle total sobre seus dados, garantindo que suas informações confidenciais permaneçam seguras e protegidas.
O que são modelos de linguagem quantizados de grande porte (LLMs quantizados)?
O hardware é o maior desafio para a maioria das pessoas que desejam usar modelos de grande linguagem (LLMs) localmente. Os modelos de IA mais poderosos exigem hardware potente para executá-los. Além da facilidade de uso, as limitações de hardware são outro motivo pelo qual a maioria dos chatbots com IA são baseados em computação em nuvem.
Limitações de hardware são um dos motivos pelos quais pensei que não conseguiria executar um modelo de linguagem grande (LLM) nativamente. Tenho um PC bastante modesto atualmente, com um processador AMD Ryzen 5800x (lançado em 2020), 32 GB de RAM DDR4 e uma GPU GTX 1070 (lançada em 2016). Portanto, não é um hardware de ponta, mas considerando o quão pouco jogo atualmente (e quando jogo, escolho... Jogos indie mais antigos e com menor consumo de recursos) e o alto custo das GPUs modernas, estou feliz com o que tenho.
No entanto, acontece que você não precisa do modelo de IA mais poderoso. Modelos de Linguagem Grandes Quantizados (LLMs Quantizados) Eles são modelos de IA que ficaram menores e mais rápidos ao simplificar os dados que usam, especialmente números com ponto decimal.
A IA normalmente opera com números de alta precisão (como decimais de 32 bits), que consomem quantidades significativas de memória e poder de processamento. A quantização reduz esses números a números de menor precisão (como inteiros de 8 bits) sem alterar significativamente o comportamento do modelo. Isso significa que o modelo roda mais rápido, usa menos espaço de armazenamento e pode ser executado em dispositivos menores (como smartphones ou hardware periférico), embora às vezes com uma ligeira perda de precisão.



Isso significa que, embora meu hardware antigo certamente tivesse dificuldade para executar um modelo de linguagem grande (LLM) tão poderoso quanto o Llama 3.1 de 205 bilhões de parâmetros, ele poderia executar o modelo quântico menor de 8 bilhões.
E quando Sobre OpenAI Para meus primeiros modelos de inferência aberta e ponderada totalmente quantizados, pensei que era hora de ver o quão bem eles funcionavam no meu antigo hardware.
Como usar um modelo de linguagem grande (LLM) localmente com uma placa de vídeo Nvidia GTX 1070 e o LM Studio?
Gostaria de começar esta seção observando que não sou especialista em modelos locais de grande linguagem (LLMs), nem no software que usei para executar este modelo inteligente na minha máquina. O que apresentarei aqui é simplesmente uma descrição do que fiz para executar um chatbot inteligente localmente na minha placa de vídeo GTX 1070, bem como uma avaliação da eficiência desta solução. O objetivo é demonstrar como você pode aproveitar seu poder computacional disponível para executar modelos avançados de IA sem precisar depender de serviços em nuvem.
Baixar LM Studio
Para executar um modelo de linguagem grande (LLM) localmente, você precisa de um software especializado. Especificamente, um programa Estúdio LM, uma ferramenta gratuita que permite baixar e executar modelos LLM localmente no seu dispositivo. Acesse a página inicial do LM Studio e escolha Baixar para [sistema operacional] (Eu uso o Windows 10.) O LM Studio é uma plataforma ideal para desenvolvedores e pesquisadores que desejam experimentar diferentes modelos de linguagem de grande porte e avaliar seu desempenho em suas máquinas pessoais antes de implantá-los.
Este é um processo de instalação padrão do Windows. Execute o programa de instalação, conclua a instalação e inicie o LM Studio. Recomendo escolher o Power User Porque ele revela algumas opções úteis que você pode querer explorar. Esta opção oferece maior controle sobre as configurações do programa e opções avançadas para personalizar a experiência de uso de modelos LLM. Com o LM Studio, você pode explorar o mundo dos grandes modelos de linguagem com facilidade e eficiência.
Baixe seu primeiro modelo de IA local
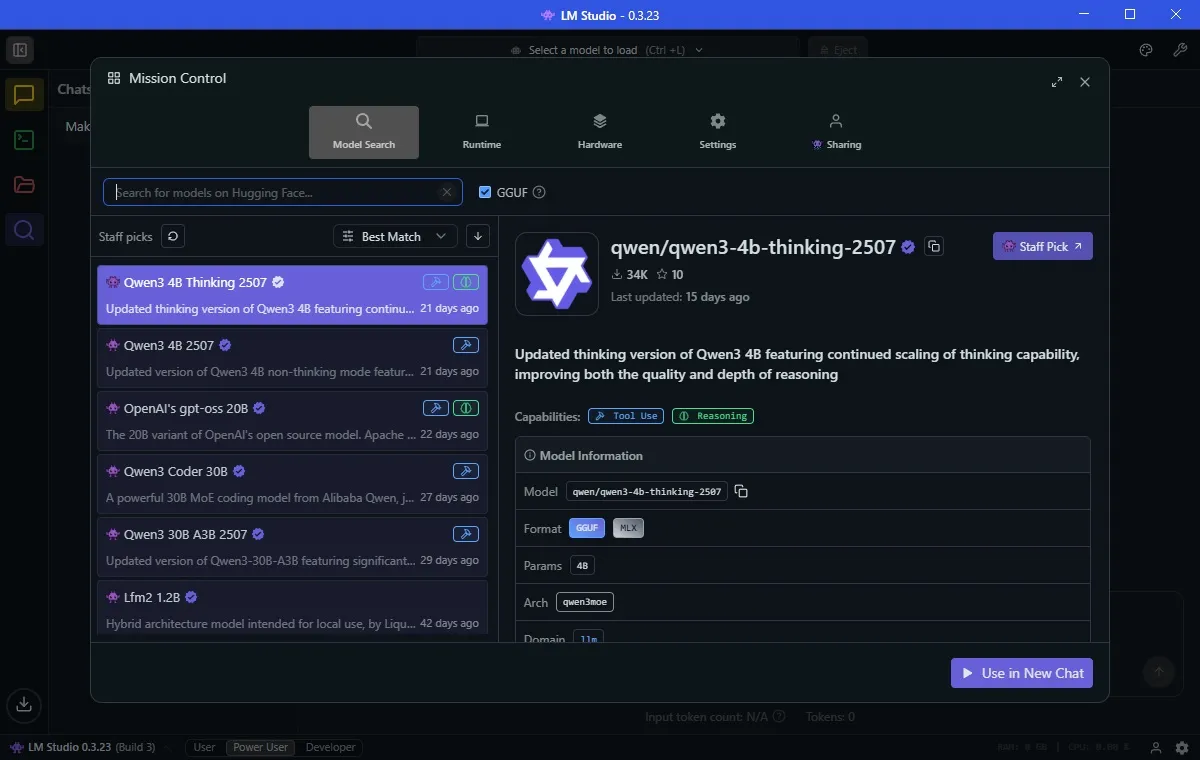
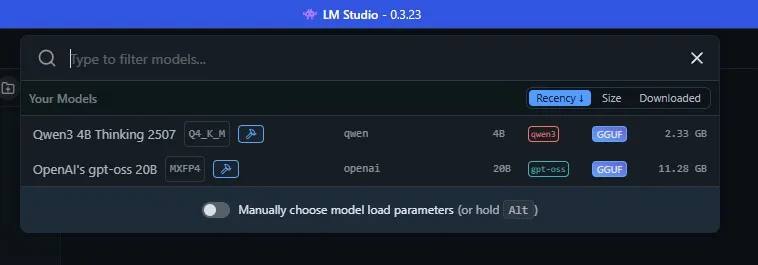
Após a instalação, você pode carregar seu primeiro modelo de linguagem grande (LLM). Selecione a guia Descubra (Ícone de lupa). O LM Studio exibe facilmente os modelos nativos de IA que funcionam melhor no seu dispositivo.
No meu caso, ele sugere baixar um modelo chamado Qwen 3-4b-pensando-2507O nome do modelo é Qwen (Desenvolvido pela gigante tecnológica chinesa Alibaba), que é a terceira versão deste modelo. O valor "4b" significa que este modelo possui quatro bilhões de parâmetros para responder a você, enquanto "pensando" significa que este modelo levará um tempo considerando sua resposta antes de responder. Por fim, 2507 é a última vez que este modelo foi atualizado, em 25 de julho.
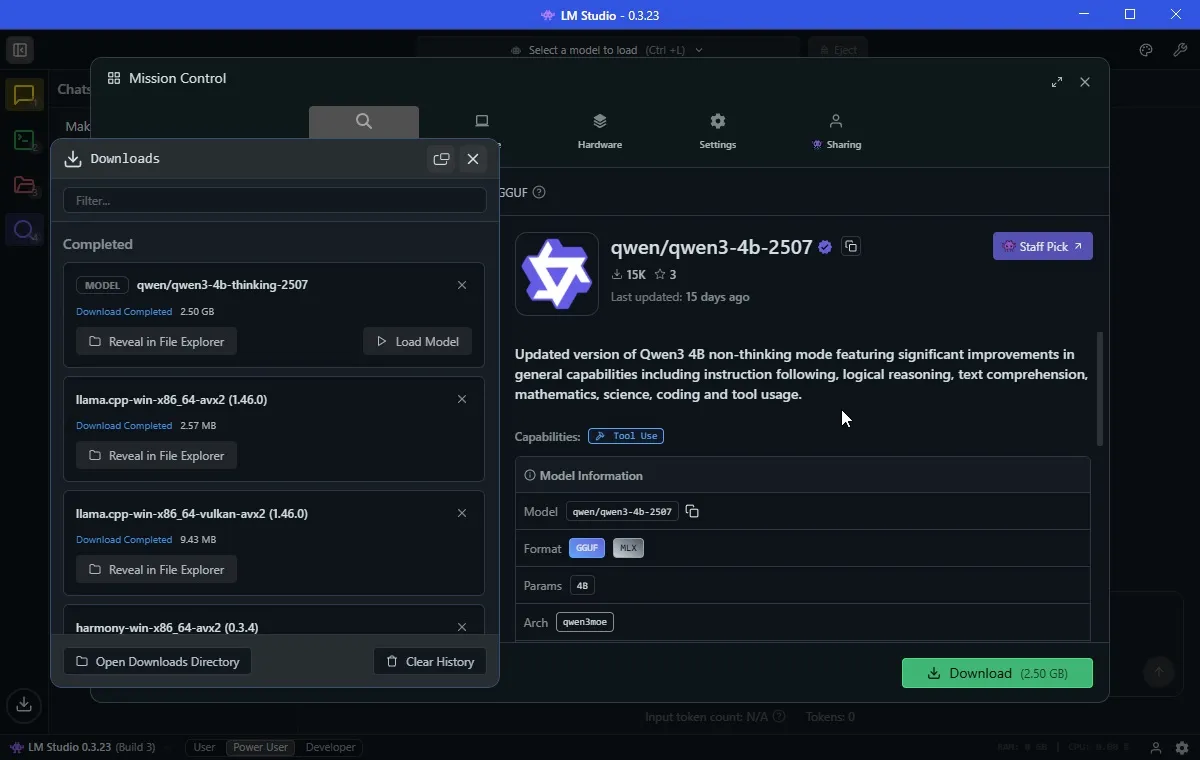
O Qwen3-4b-thinking tem apenas 2.5 GB, então não deve demorar muito para baixar. Eu também baixei anteriormente o OpenAI/gpt-oss-20b, que é maior, com 12.11 GB. Ele também contém 20 bilhões de parâmetros, então deve fornecer respostas "melhores", embora tenha um custo de recursos maior.
Agora, além de As complexidades da nomenclatura de modelos de IADepois de baixar o LLM, você estará quase pronto para começar a usá-lo.
Antes de executar o modelo de IA, vá para a aba Hardware Certifique-se de que o LM Studio identifique corretamente o seu sistema. Você também pode rolar para baixo e ajustar guardrails Aqui. Configurei os firewalls do meu computador para Equilibrado, evitando que qualquer modelo de IA consuma muitos recursos, o que poderia causar sobrecarga do sistema.
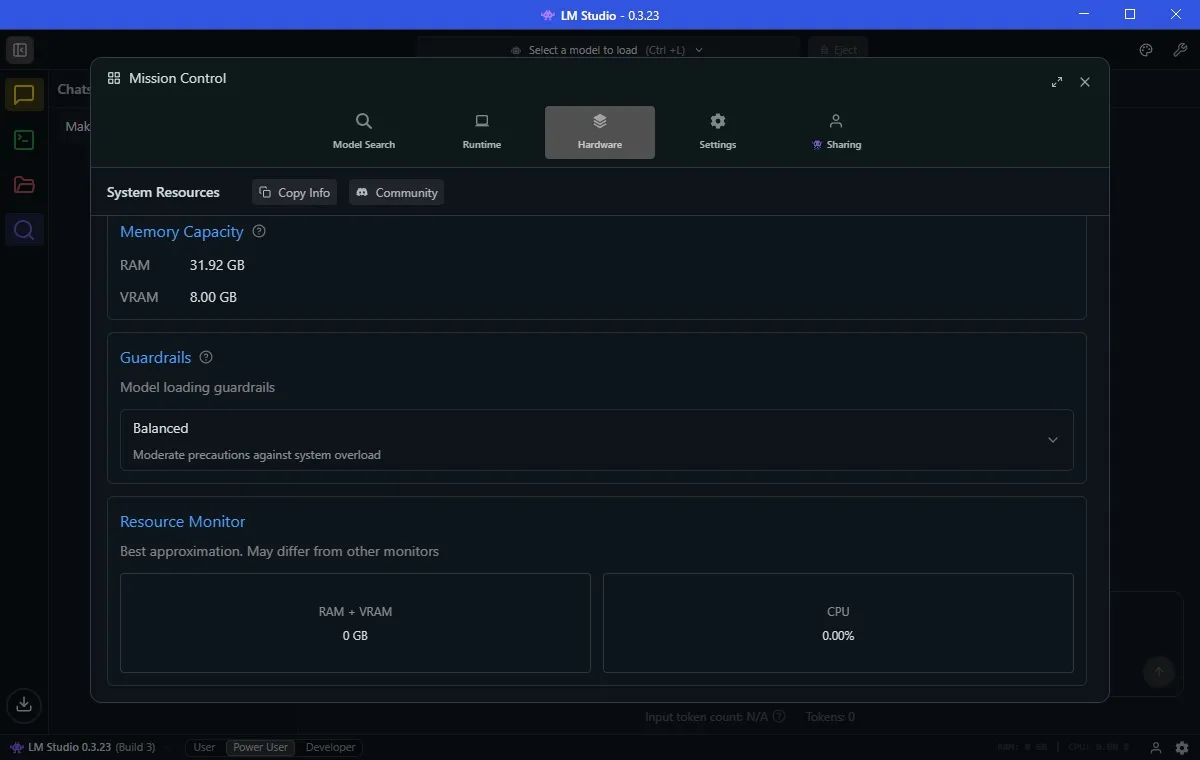
Você também notará Monitor de recursos Abaixo dos Guardrails. Esta é uma maneira fácil de ver quanto uso do sistema seu modelo de IA está consumindo. Vale a pena monitorar se você estiver usando hardware bastante limitado, como eu, para não querer que seu sistema trave inesperadamente.
Carregue seu modelo de IA e comece a usá-lo.
Agora você está pronto para começar a usar seu chatbot de IA localmente no seu dispositivo. No LM Studio, selecione a barra superior, que funciona como uma ferramenta de pesquisa. Selecionar o nome da IA carregará o modelo de IA na memória do seu computador, e você poderá começar a inserir comandos e perguntas. Esse processo é necessário para habilitar os recursos do modelo de linguagem de grande porte (LLM) diretamente no seu dispositivo, permitindo que você experimente a IA de forma interativa e rápida, sem a necessidade de uma conexão constante com a internet. Lembre-se de que o desempenho do modelo depende das especificações do seu dispositivo, portanto, certifique-se de ter recursos suficientes para executar seu modelo de IA com eficiência.
Executar um modelo de IA localmente em hardware mais antigo: ótimo, mas com limitações
Executar um modelo de IA localmente permite que você se beneficie dele da maneira usual, mas esteja ciente de algumas limitações importantes. Esses modelos locais, embora úteis, não são tão poderosos quanto modelos de última geração, como o GPT-5 usado no ChatGPT. Além disso, você notará que o processo de pensamento e resposta leva muito mais tempo, e a qualidade das respostas pode variar significativamente.
Para ilustrar, testei um modelo clássico de grande linguagem (LLM) tanto no Qwen quanto no gpt-oss, e ambos conseguiram concluir a tarefa, embora após uma longa espera. Isso demonstra que usar um modelo de IA nativo em uma máquina mais antiga pode ser uma solução prática, mas requer paciência e compreensão das limitações de hardware mais antigo.
Allen, Bob, Colin, Dave e Emily estão em círculo. Allen está imediatamente à esquerda de Bob. Bob está imediatamente à esquerda de Colin. Colin está imediatamente à esquerda de Dave. Dave está imediatamente à esquerda de Emily. Quem está imediatamente à direita de Allen?
Qwen levou 5 minutos e 11 segundos para chegar à conclusão correta. O GPT-5 levou apenas cerca de 45 segundos. Mas quem superou todos? O gpt-oss-20b com um tempo recorde de 31 segundos.
Um teste não é suficiente, então tentei em outro quebra-cabeça projetado para testar as habilidades de raciocínio da IA. Em um teste anterior, o modelo mais recente da OpenAI, o GPT-5, falhou neste teste, então eu estava ansioso para ver como as versões offline do Qwen e do gpt-oss se sairiam.
Análise do desempenho de modelos de inteligência artificial na resolução de problemas lógicos
A capacidade de resolver problemas lógicos é um verdadeiro desafio para modelos de IA. O exemplo acima, que envolve a identificação de relações espaciais entre um grupo de pessoas, ilustra quão variável o desempenho desses modelos pode ser.
Relações Espaciais e os Desafios da Inteligência Artificial
O processamento de relações espaciais é uma parte fundamental da inteligência artificial, exigindo um profundo conhecimento da linguagem e a capacidade de raciocinar logicamente. O exemplo anterior demonstra que alguns modelos, como o gpt-oss-20b, se destacam nessa tarefa, enquanto outros, como o Qwen e o GPT-5, demoram mais para chegar à solução correta.
A importância de vários testes para avaliar a inteligência artificial
Não se pode confiar em um único teste para avaliar de forma abrangente as capacidades da IA. É necessário realizar uma variedade de testes abrangendo diferentes aspectos da inteligência, como raciocínio lógico, compreensão da linguagem e resolução de problemas complexos. Isso permite uma avaliação mais precisa das capacidades e limitações de cada modelo.
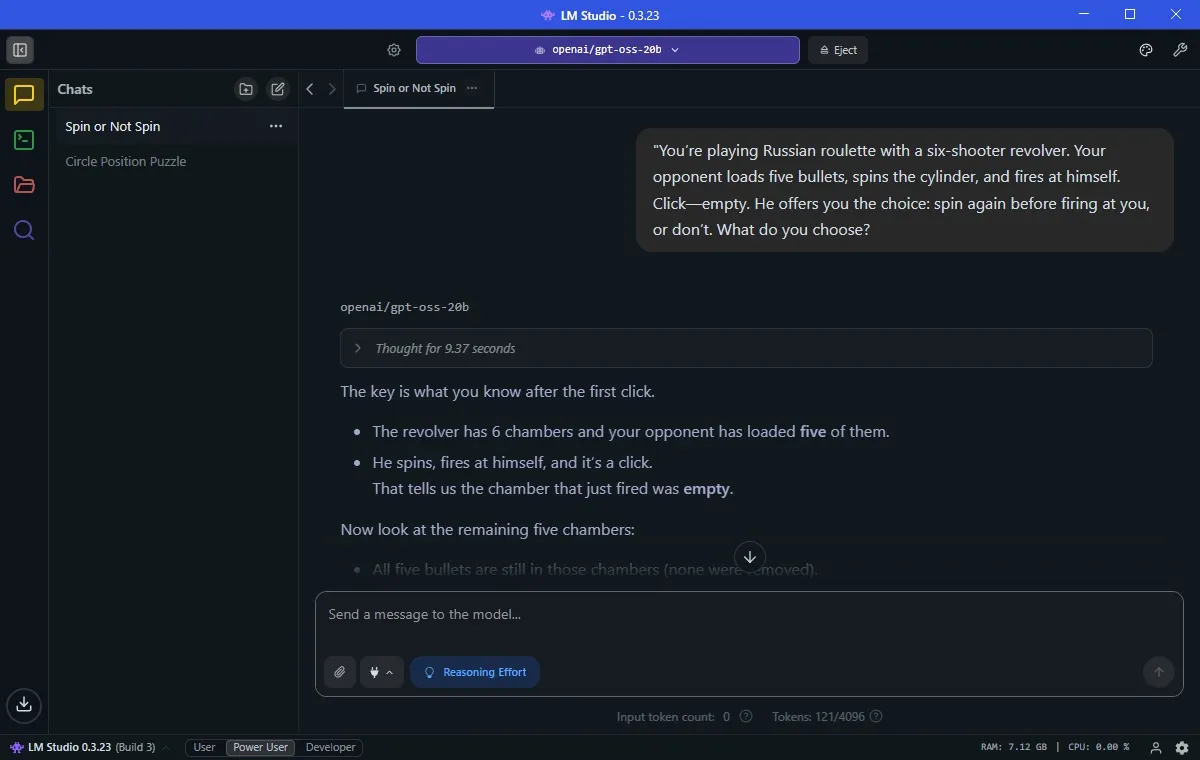
Imagine que você está jogando roleta-russa com uma pistola de seis tiros. Seu oponente carrega cinco balas, gira o tambor e atira em si mesmo. "Tick" significa vazio. Ele então lhe oferece uma escolha: você quer girar o tambor novamente antes que ele atire em você, ou não? O que você escolhe?
O modelo Qwen conseguiu dar a resposta correta em 41 minuto e 5 segundos, o que é um tempo muito bom (considerando as limitações de hardware). Surpreendentemente, porém, o GPT-20 não conseguiu resolver esse problema, o que é realmente surpreendente. Ele até se ofereceu para me fornecer um gráfico mostrando por que estava correto. Mais uma vez, o gpt-oss-9b acertou a resposta em apenas XNUMX segundos.
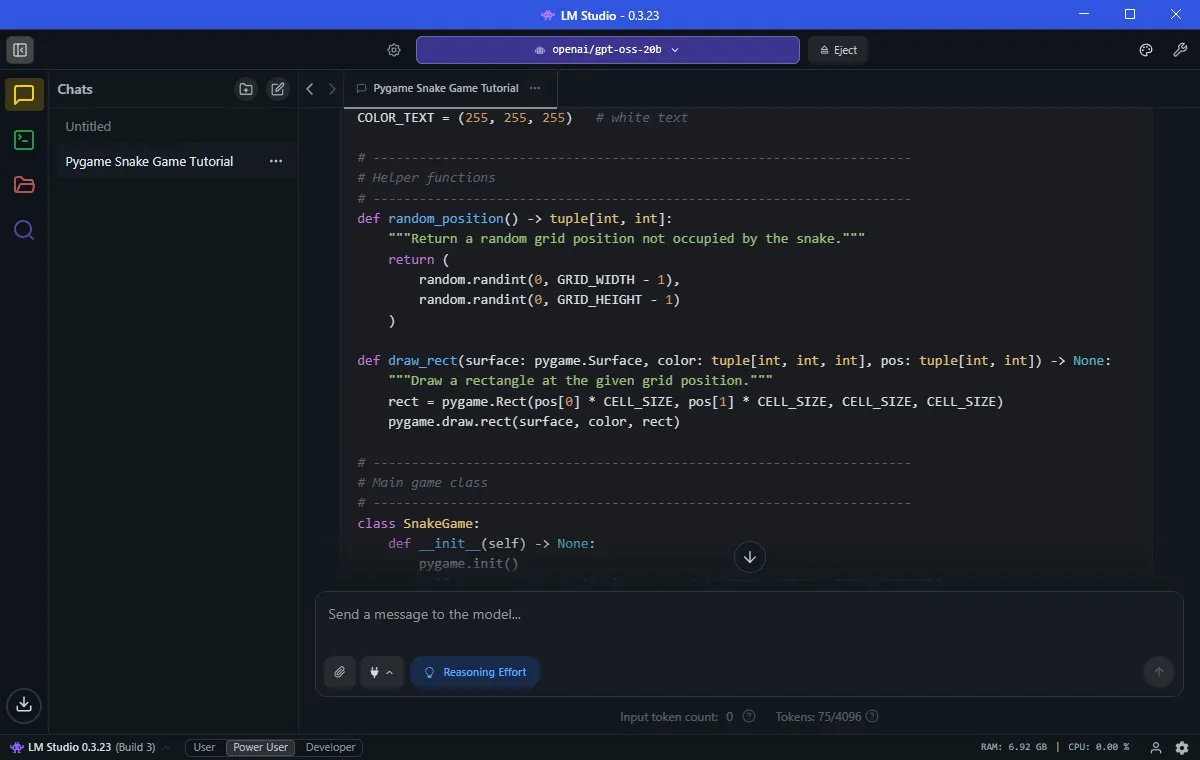
Em outras áreas, também obtive sucesso imediato. Pedi ao gpt-oss para "escrever um jogo da cobrinha para mim usando o pygame" e, em um ou dois minutos, eu tinha um jogo da cobrinha totalmente funcional. Isso demonstra a capacidade do modelo de gerar jogos com eficiência.
Executando um modelo de IA em seus dispositivos antigos
A chave para executar um modelo de linguagem grande (LLM) nativamente em hardware mais antigo é escolher o modelo de IA certo para as capacidades do seu hardware. Embora a versão Qwen tenha apresentado bom desempenho e tenha sido a melhor escolha no LM Studio, o modelo gpt-oss-20b da OpenAI é claramente uma escolha muito superior.
Mas é importante equilibrar suas expectativas. Embora o gpt-oss tenha respondido às perguntas com precisão (e mais rápido que o GPT-5), não conseguirei enviar uma quantidade enorme de dados para ele processar. As limitações do meu hardware logo se tornarão aparentes.
Antes de tentar, eu estava convencido de que executar um chatbot de IA nativo no meu hardware antigo era impossível. Mas, graças a modelos quânticos e ferramentas como o LM Studio, isso não só é possível, como também surpreendentemente útil.
No entanto, você não obterá a mesma velocidade, precisão ou profundidade de raciocínio que obteria com algo como o GPT-5 na nuvem. Executar localmente envolve compensações: você ganha privacidade, acesso offline e controle sobre seus dados, mas abre mão de algum desempenho.
No entanto, o fato de uma GPU de sete anos e uma CPU de quatro anos conseguirem lidar com a IA moderna é muito empolgante. Se você está hesitante por não ter hardware de ponta, não se preocupe — modelos quânticos locais podem ser o seu caminho para a IA offline. Use o modelo de IA certo para aproveitar ao máximo seu hardware antigo.